Wenn KI-Systeme Websites auslesen, profitieren die Urheber nicht automatisch davon. Cloudflare will mit Pay Per Crawl bezahlten Zugriff ermöglichen. Eine Chance für Content-Anbieter – mit Folgen für Sichtbarkeit und das offene Web.
Das erwartet dich
- Wie funktioniert Pay Per Crawl?
- Die Chance für Websitebetreiber und Content-Ersteller
- SEO: Wo eine Bezahlschranke Sichtbarkeit kosten kann
- Welche Seiten sollten frei erreichbar bleiben?
- Risiken und Grenzen der Beta
- Was sollten Unternehmen jetzt tun?
Wer liest unsere Websites – und wer profitiert davon?
Websites werden seit Jahrzehnten von Suchmaschinen durchsucht. Im besten Fall erhalten sie dafür Besucher zurück: Ein Suchergebnis führt zur Originalseite. KI-Crawler können Inhalte ebenfalls abrufen, etwa für KI-Dienste oder Modelle. Dabei muss aus einem Abruf nicht automatisch ein Besuch auf der Quellwebsite entstehen. Für Betreiber, die viel Arbeit in Recherche, Texte, Bilder oder Daten stecken, stellt sich deshalb eine neue Frage: Wer darf diese Inhalte maschinell nutzen – und zu welchen Bedingungen?
Cloudflare Pay Per Crawl ist ein Versuch, darauf eine technische Antwort zu geben. Die Funktion ermöglicht es teilnehmenden Websites, von ausgewählten KI-Crawlern einen Preis pro erfolgreichem Seitenabruf zu verlangen. Es geht dabei um den Zugriff des Crawlers, nicht um eine Bezahlschranke für menschliche Besucher. Pay Per Crawl befindet sich derzeit in einer geschlossenen Beta und ist noch kein allgemeiner Standard des Internets.
Wie funktioniert Pay Per Crawl?
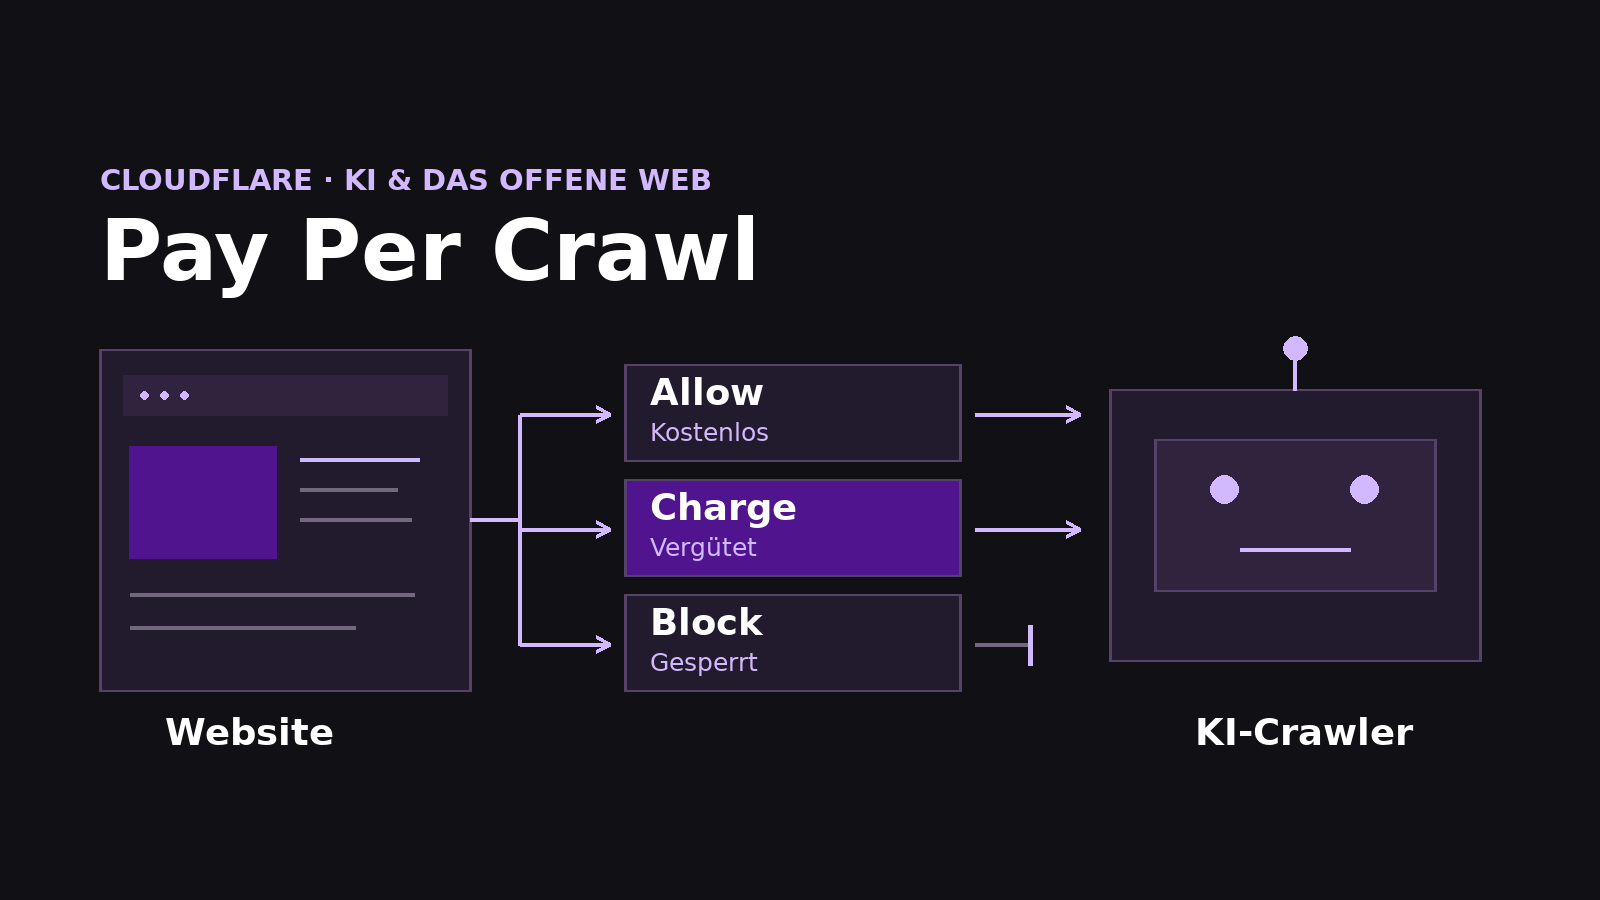
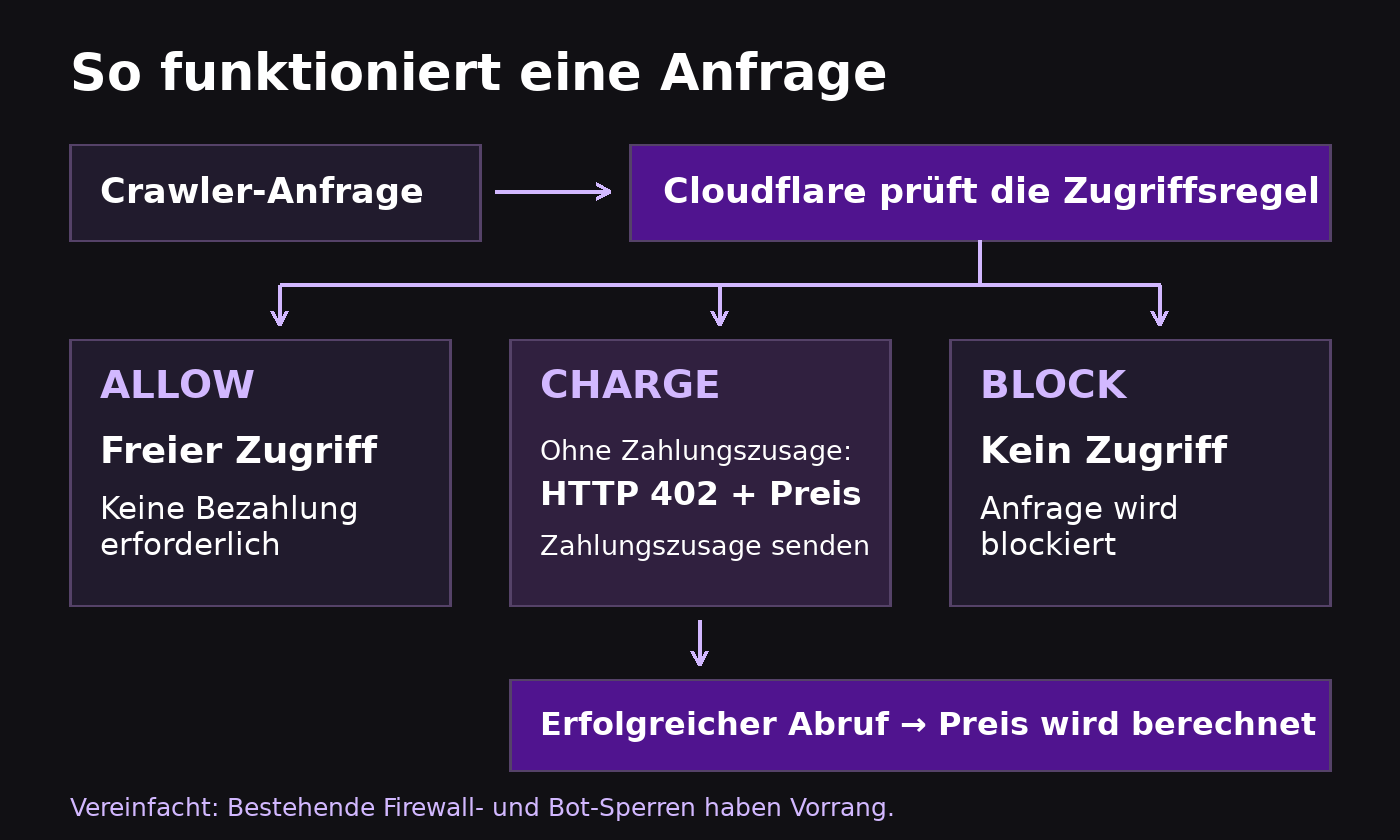
Websitebetreiber legen in Cloudflares AI Crawl Control einen Preis fest und bestimmen je Crawler die Aktion Allow, Charge oder Block. „Allow“ lässt den Zugriff kostenlos zu, „Charge“ verlangt Bezahlung, „Block“ verhindert den Zugriff. Ruft ein betroffener Crawler eine kostenpflichtige Seite ohne Zahlungszusage ab, erhält er eine Antwort mit dem HTTP-Status 402 Payment Required und dem Preis. Ein verifizierter Crawler kann seinen Zahlungswillen über signierte Anfrage-Header erklären. Bei erfolgreichem Abruf wird der eingestellte Betrag berechnet; die Zahlungsabwicklung läuft über Cloudflare und Stripe.
Das ist eine infrastrukturelle Schnittstelle zwischen Website und Crawler. Sie garantiert weder, dass jeder KI-Anbieter zahlt, noch dass jeder Inhalt dadurch Einnahmen erzielt. Ein Anbieter kann entscheiden, die Seite nicht abzurufen. Zudem können bereits vorhandene Firewall- oder Bot-Regeln den Crawler vorher blockieren, sodass die Bezahlregel gar nicht greift.
Warum führt Cloudflare das ein?
Cloudflare reagiert auf ein wirtschaftliches Ungleichgewicht: Inhalte werden für automatisierte Dienste wertvoll, während die ursprüngliche Website möglicherweise kaum Besuche oder Erlöse erhält. Bisher standen Betreiber häufig vor der Wahl, Crawler zuzulassen oder sie zu sperren. Ein Preis pro Abruf schafft eine weitere Option: Zugriff gegen Vergütung.
Langfristig könnte daraus ein Markt für maschinell nutzbare Inhalte entstehen. Nachrichtenangebote, Fachportale oder spezialisierte Datenanbieter hätten eine Möglichkeit, Nutzung und Gegenleistung direkt zu verknüpfen. Ob das funktioniert, hängt aber von der Nachfrage und der Bereitschaft der KI-Anbieter ab, solche Preise tatsächlich zu akzeptieren.
Die Chance für Websitebetreiber und Content-Ersteller
Für Seiten mit eigenständigen, regelmäßig aktualisierten Inhalten kann ein bezahlter Crawl zusätzliche Erlöse eröffnen. Betreiber erhalten außerdem mehr Kontrolle darüber, welche automatisierten Dienste kostenlos lesen, bezahlen oder keinen Zugang erhalten. Statt alle Bots gleich zu behandeln, lässt sich die Regel nach Crawler und bestimmten Seitenbereichen steuern.
Der mögliche Nutzen ist besonders dort interessant, wo Inhalte teuer entstehen und für KI-Systeme einen klaren Wert haben. Ein kleiner Unternehmensblog sollte dagegen keine sicheren Einnahmen erwarten: Ohne nennenswertes Interesse zahlender Crawler bleibt der Ertrag gering. Pay Per Crawl ist kein Ersatz für Reichweite, Kundenanfragen, Abonnements oder bestehende Lizenzmodelle.
SEO: Wo eine Bezahlschranke Sichtbarkeit kosten kann
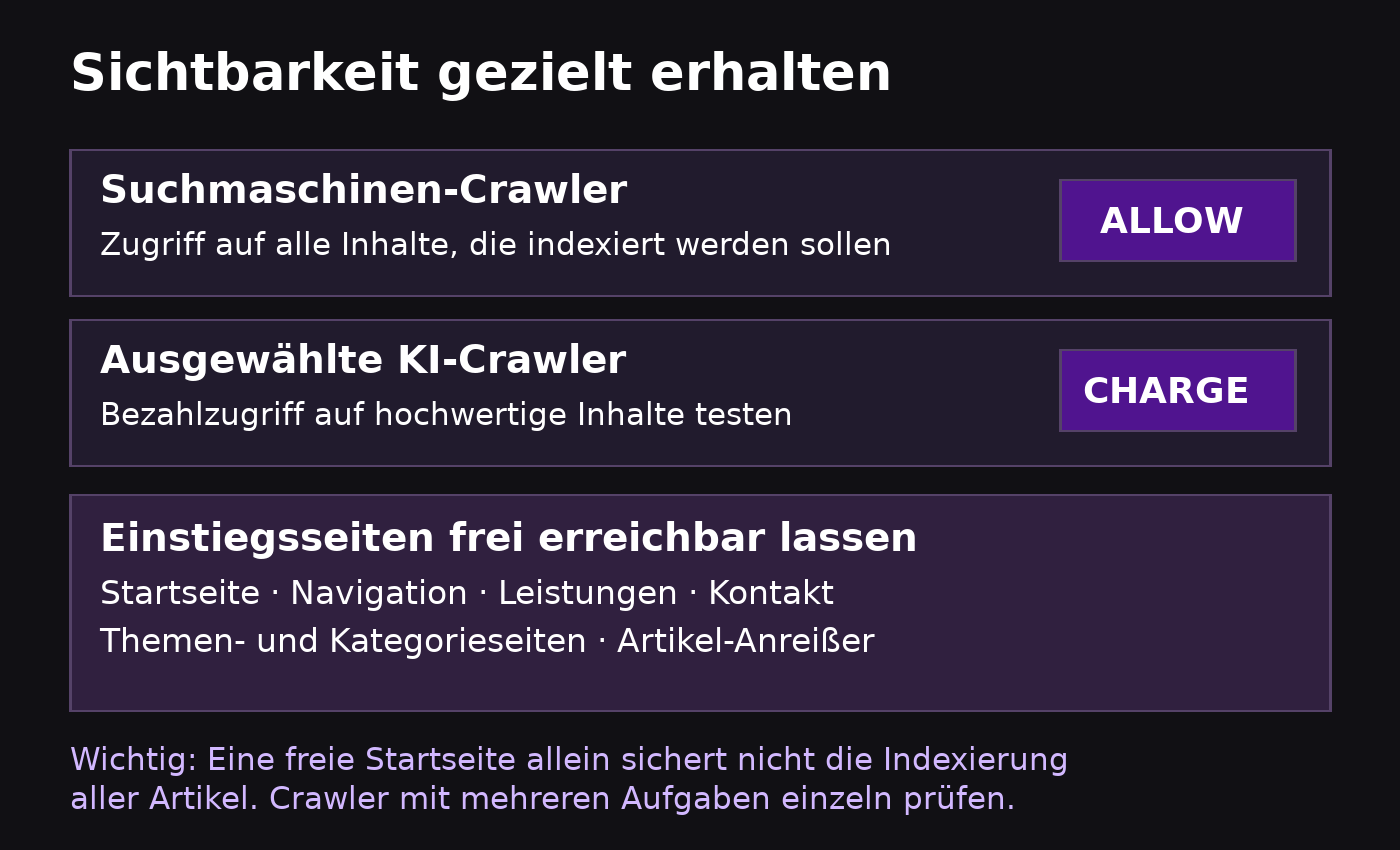
Die wichtigste Einstellung ist die Auswahl der Crawler. Cloudflare warnt ausdrücklich: Werden Search-Engine-Crawler auf „Charge“ oder „Block“ gesetzt, können Suchmaschinen Inhalte möglicherweise nicht richtig indexieren. Das kann die Auffindbarkeit in der organischen Suche beeinträchtigen. Wer über Google, Bing oder andere Suchmaschinen gefunden werden möchte, sollte deren relevante Such-Crawler gezielt auf Allow lassen und Änderungen anschließend in den jeweiligen Webmaster-Tools und Serverdaten prüfen.
Vorsicht ist auch bei Crawlern mit mehreren Aufgaben geboten. Nicht jeder Bot lässt sich sauber in „Suche“ und „KI“ einordnen. Eine pauschale Sperre kann daher mehr treffen als beabsichtigt. Die praktische Frage lautet nicht nur „Darf KI das lesen?“, sondern auch: „Über welchen Crawler gelangen potenzielle Kunden künftig zu uns?“ Auswirkungen auf KI-Suche und Empfehlungen sind möglich, aber nicht für jede Plattform gleich; feste Ranking-Versprechen oder pauschale SEO-Prognosen wären unseriös.
Welche Seiten sollten frei erreichbar bleiben?
Ein sinnvoller Einstieg ist eine offene Schicht für Orientierung und Entdeckung: Startseite, Navigation, Leistungsübersichten, Kontaktseite, Themen- und Kategorieseiten sowie gegebenenfalls kurze Anreißer zu Fachartikeln. So können Crawler die Struktur verstehen und interessante Inhalte finden. Cloudflare ermöglicht es, bestimmte URL-Muster über Konfigurationsregeln von Pay Per Crawl auszunehmen. Für einige technische Dateien, darunter robots.txt und sitemap.xml, ist der Crawl laut Cloudflare ohnehin kostenlos.
Die Entscheidung sollte sich nach dem Zweck jeder Seite richten. Inhalte, die Anfragen oder Sichtbarkeit erzeugen sollen, profitieren meist von freiem Zugang für Suchmaschinen. Für umfangreiche, exklusive Recherchen oder hochwertige Datensammlungen kann ein bezahlter Zugriff auf ausgewählte KI-Crawler eher sinnvoll sein. Eine Ausnahme für die Startseite allein schützt die Indexierung der übrigen Artikel nicht, wenn der zuständige Such-Crawler dort weiterhin auf „Charge“ oder „Block“ steht.
Risiken und Grenzen der Beta
- Weniger Reichweite: Wer relevante Crawler sperrt oder zur Zahlung auffordert, riskiert, in deren Diensten seltener oder gar nicht aufzutauchen. Besonders kritisch ist das für Suchmaschinen.
- Unsichere Einnahmen: Bezahlt wird nur, wenn ein unterstützter, teilnehmender Crawler die Inhalte erfolgreich abruft. Der Betreiber kann pro Cloudflare-Zone einen Standardpreis festlegen, derzeit aber nicht für jeden Crawler einen anderen Preis im einfachen Modell. Wiederholte erfolgreiche Abrufe können erneut kostenpflichtig sein; Crawler könnten deshalb sparsamer abrufen.
- Technische und strategische Abhängigkeit: Das Modell setzt auf Cloudflares Erkennung, Regeln und Zahlungsinfrastruktur. Zugleich müssen Crawler verifiziert sein und die Bezahltechnik unterstützen. Andere oder falsch identifizierte Abrufe können außerhalb dieses Modells liegen. Bestehende WAF- und Bot-Sperren haben Vorrang.
- Fragen für das offene Web: Wenn immer mehr Inhalte nur noch gegen Zahlung für Maschinen erreichbar sind, könnten große KI-Unternehmen leichter umfassende Zugänge finanzieren als kleinere Anbieter, Forschende oder gemeinnützige Projekte. Umgekehrt kann Vergütung helfen, unabhängige Inhalte wirtschaftlich zu erhalten. Beides sind mögliche Entwicklungen, keine bereits belegten Folgen von Pay Per Crawl.
Was sollten Unternehmen jetzt tun?
Zuerst lohnt ein Blick auf den eigenen KI- und Suchmaschinen-Traffic: Welche Bots kommen, welche Seiten rufen sie ab und welche Besuche oder Anfragen entstehen daraus? Danach lassen sich Ziele je Inhaltsart festlegen. Für eine Unternehmenswebsite dürfte meist gelten: Suchmaschinen erreichbar halten, zentrale Einstiegsseiten frei lassen und nur bei besonders wertvollen Inhalten eine Bezahlregel für geeignete KI-Crawler testen. Änderungen sollten schrittweise erfolgen und über Indexierungsberichte, organischen Traffic und Crawler-Logs beobachtet werden.
Pay Per Crawl verschiebt die Grundfrage des Webs: Reicht Sichtbarkeit als Gegenleistung für automatisierten Zugriff, oder braucht es künftig häufiger eine direkte Vergütung? Die Antwort wird nicht eine einzige Einstellung liefern. Sie entsteht aus der Balance zwischen Schutz, Einnahmen und Auffindbarkeit – und aus der Frage, wie offen das Internet für neue Anbieter und Nutzer bleiben soll.
Quellen und weiterführende Informationen
- Cloudflare: Was ist Pay Per Crawl?
- Cloudflare: Crawler auswählen und SEO-Hinweis
- Cloudflare: FAQ zu Preisen und wiederholten Abrufen
- Cloudflare: Ausnahmen für frei erreichbare Seiten
- Cloudflare: Einführung und Motivation
Stand: 29. September 2026. Pay Per Crawl befindet sich in einer geschlossenen Beta; Funktionen und Bedingungen können sich ändern.